개발자를 위한 행사 정보, 데브이벤트

Today
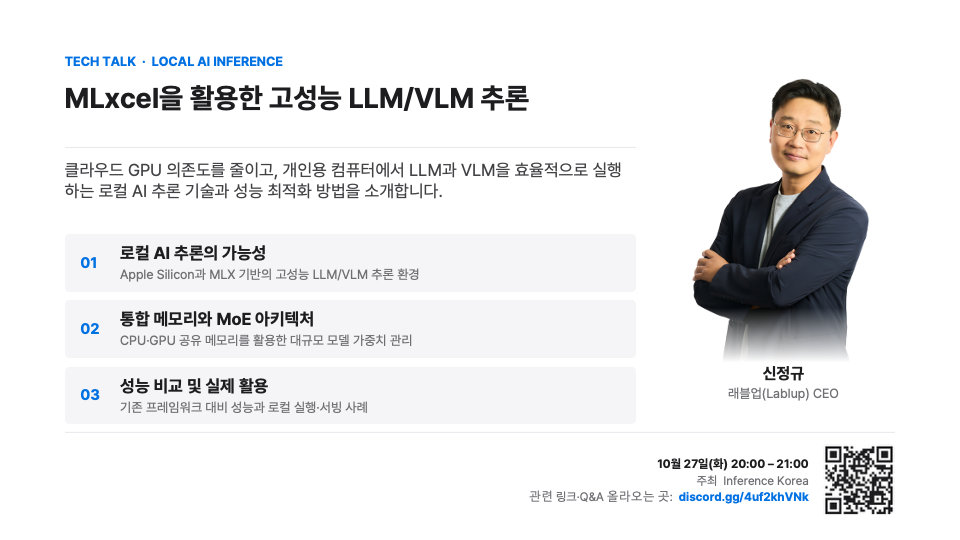
로컬 AI 추론 커뮤니티 Inference Korea가 여는 온라인 밋업입니다. 클라우드 GPU 의존도를 줄이고 개인용 컴퓨터에서 LLM과 VLM을 효율적으로 실행하는 로컬 AI 추론 기술과 성능 최적화 방법을, MLxcel을 활용한 고성능 LLM/VLM 추론 사례로 소개합니다.
다루는 내용
- 로컬 AI 추론의 가능성 — Apple Silicon과 MLX 기반의 고성능 LLM/VLM 추론 환경
- 통합 메모리와 MoE 아키텍처 — CPU·GPU 공유 메모리를 활용한 대규모 모델 가중치 관리
- 성능 비교 및 실제 활용 — 기존 프레임워크 대비 성능과 로컬 실행·서빙 사례
연사
- 신정규 (래블업(Lablup) CEO) — TECH TALK 「MLxcel을 활용한 고성능 LLM/VLM 추론」
참가 안내
- 무료 온라인 밋업이며 Zoom으로 진행합니다.
- 행사 안내와 Zoom 접속 링크, 관련 링크와 Q&A는 Inference Korea 디스코드 서버에서 공유됩니다.
행사 요약
| 항목 | 내용 |
|---|---|
| 일시 | 2026. 10. 27(화) 20:00 ~ 21:00 (연사 안내 이미지 기준 — 신청 페이지 일시 칸에는 08:00 ~ 09:30으로 표기) |
| 장소 | 온라인 (Zoom) |
| 참가비 | 무료 |
| 접수 | 2026. 10. 22(목) 23:00 ~ 10. 26(월) 20:00 |
| 주최 | Inference Korea |
